그동안 Blogger 를 사용했는데, 코드 설명이나 글 쓰기가 불편하기도 하고...
Markdown 에 꼿혀서, Tumblr 로 이사하게 되었습니다.
주소는 http://debop.tumblr.com 이구요.
벌써 석달은 된 거 같군요.
사실 한동안 바빠서 글도 못썼네요. 앞으로는 tumblr 에 자주 글을 올릴 계획입니다^^
2013년 11월 27일 수요일


2013년 7월 30일 화요일
IntelliJ 에서 TODO 외에 것을 추가해보자.
VS.NET 에 Resharper 를 사용할 때에는 TODO 외에 BUG, HINT, NOTE 등을 추가하여, 개발 시에 주의할 점을 특별히 기록하곤 했습니다만, IntelliJ 에서는 TODO 만 되는 줄 알았네요. 우연히 다른 것 때문에 보다보니 TODO 외에도 추가할 수 있더군요.
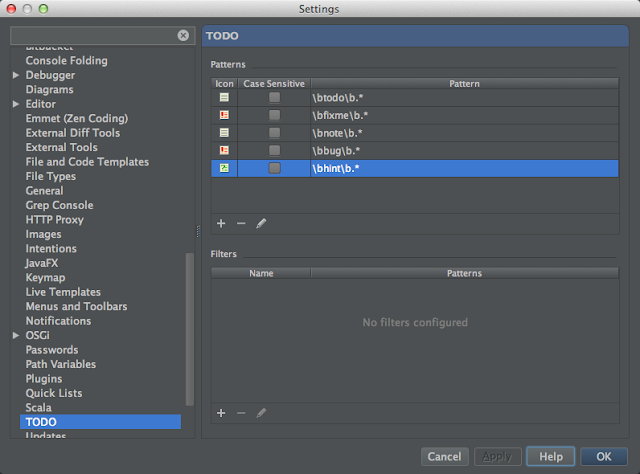
보시면 todo, fixme 가 기본적으로 제공되고, 정규식으로 comment 에서 위의 글자로 시작하면 데코레이션을 수행해 줍니다.
전 여기에 note, bug, hint 를 추가했습니다.
에디터에서 추가한 것이 어떻게 나오나 봤습니다... 짜잔~

이쁘게 나왔죠? 원하는 색상도 가능하고, 스크롤 바에 표시도 가능합니다.
제가 Note 나 Hint 를 많이 쓰고 싶었는데 이제서야 알게 되었네요.

IntelliJ Settings -> TODO
보시면 todo, fixme 가 기본적으로 제공되고, 정규식으로 comment 에서 위의 글자로 시작하면 데코레이션을 수행해 줍니다.
전 여기에 note, bug, hint 를 추가했습니다.
에디터에서 추가한 것이 어떻게 나오나 봤습니다... 짜잔~

이쁘게 나왔죠? 원하는 색상도 가능하고, 스크롤 바에 표시도 가능합니다.
제가 Note 나 Hint 를 많이 쓰고 싶었는데 이제서야 알게 되었네요.
2013년 7월 21일 일요일
MySql Master-Slave Replication 에서 JPA 사용하기
전편의 MySql Master-Slave Replication 에서 Hiberante 사용하기 에서 몇가지 개선 사항과 JPA에도 적용하기 위해 몇가지 사항을 바꿨습니다.
1. Transactional annotation 의 readOnly 가 true 일때만 point cut 하기
2. Session.connection() 이 폐기될 것이므로 doWork() 를 사용하도록 하기 입니다.
MySqlConnectionInterceptor.java
소스를 보면 point cut 에 annotation(transactional) 다음에 "if transactional.readOnly()" 를 추가하여, @Transactional(readOnly=true) 로 지정된 메소드만 intercept 하도록 했습니다.
이렇게 하면 부가적인 인터셉트 과정을 거치지 않아서 좋겠지요.
두번째는 Hibernate Session#connection() 이 deprecated 된다고, doWork() 를 추천하더군요. 그래서 Connection을 readOnly 로 지정하는 Work와 복원하는 Work 를 구현하여 사용했습니다.
한가지 제가 아직 해결 못한게, Intercepting 하고자 하는 메소드가 Concrete class 만 가능하고, Interface는 안되는 군요... 이 것 때문에 Spring-Data-Jpa 의 JpaRepository 에 직접 @Transactional 을 할 수 없고, Business Logic 의 Service Component 에 Transactional 을 지정해 주셔야 합니다.
개인적으로 Hibernate 자체를 사용하는 것을 선호했지만, Spring-Data-Jpa 의 많은 장점을 보고, JPA 로 넘어가려고 합니다.
앞으로는 JPA 를 기준으로 개발할 거 같네요.
==================
구글링을 계속 해보니, Spring 3.0 이후로는 인터페이스에 정의된 annotation 는 상속되지 않는다고 나왔네요... 쩝... 이게 자바의 규칙이라고 하네요^^
참고 :
Aspect Oriented Programming with Spring 중에 7.8.2 Other Spring aspects for AspectJ
1. Transactional annotation 의 readOnly 가 true 일때만 point cut 하기
2. Session.connection() 이 폐기될 것이므로 doWork() 를 사용하도록 하기 입니다.
MySqlConnectionInterceptor.java
소스를 보면 point cut 에 annotation(transactional) 다음에 "if transactional.readOnly()" 를 추가하여, @Transactional(readOnly=true) 로 지정된 메소드만 intercept 하도록 했습니다.
이렇게 하면 부가적인 인터셉트 과정을 거치지 않아서 좋겠지요.
두번째는 Hibernate Session#connection() 이 deprecated 된다고, doWork() 를 추천하더군요. 그래서 Connection을 readOnly 로 지정하는 Work와 복원하는 Work 를 구현하여 사용했습니다.
한가지 제가 아직 해결 못한게, Intercepting 하고자 하는 메소드가 Concrete class 만 가능하고, Interface는 안되는 군요... 이 것 때문에 Spring-Data-Jpa 의 JpaRepository 에 직접 @Transactional 을 할 수 없고, Business Logic 의 Service Component 에 Transactional 을 지정해 주셔야 합니다.
개인적으로 Hibernate 자체를 사용하는 것을 선호했지만, Spring-Data-Jpa 의 많은 장점을 보고, JPA 로 넘어가려고 합니다.
앞으로는 JPA 를 기준으로 개발할 거 같네요.
==================
구글링을 계속 해보니, Spring 3.0 이후로는 인터페이스에 정의된 annotation 는 상속되지 않는다고 나왔네요... 쩝... 이게 자바의 규칙이라고 하네요^^
AspectJ follows Java's rule that annotations on interfaces are not inherited.
참고 :
Aspect Oriented Programming with Spring 중에 7.8.2 Other Spring aspects for AspectJ
2013년 7월 20일 토요일
Spring-Data-Mongo 이용하기
NoSQL DB 중 범용성이 좋은 MongoDB 를 사용하려면 여러가지 방법이 있습니다
1. Hibernate-OGM for MongoDB
2. Spring-Data MongoDB
1번은 hibernate-core, hibernate-search, hibernate-ogm 을 활용하여 검색 시스템을 만들어봐서, 이번에는 spring-data-mongodb 를 사용해보기로 했습니다.
예전에 spring-data-jpa 에서 repository 의 concrete class 를 안 만들고, 동적으로 생성해서 사용하는 방법을 보고, 와 정말 이렇게 되면 코딩량이 엄청 줄어들겠다 싶더군요...
그래서 이번에 spring-data-mongo 의 예제를 보고, 제 나름대로 다시 구성해 봤습니다.
spring-data 의 여러가지 모듈 사용법이 더 좋고, 생산성이 높다면, 앞으로는 이 것을 계속 사용하려고 합니다...
우선 spring-data-mongo 를 사용하기 위해 dependency에 다음을 추가합니다.
pom.xml
다음으로 도메인 모델로 Album class 를 정의합니다.
Album.java
@Document 는 org.springframework.data.mongodb.core.mapping.Document 입니다.
이 어노테이션이 정의되면, MongoDB 의 Document 로 선언한 것입니다.
다음은 Album용 Repository를 정의합니다.
AlbumRepository.java
테스트용 환경 설정은 다음과 같이 합니다.
MongoConfiguration.java
주의할 점은 Repository 들을 실제 구현한 것이 아니라, Spring 이 동적으로 구현할 수 있도록 @EnableMongoRepositories 를 선언해 줘야 한다는 것입니다.
마지막으로 테스트 코드는 다음과 같습니다.
AlbumRepositoryIntegrationTest.java
를 구현하면 됩니다.
나머지 코드는 Spring-Data Mongo 의 예제에 있습니다. 그 예제는 xml 로 환경설정을 하고, 몇가지 제가 필요없는 코드를 제거했습니다.
시간나면 github에 따로 분리해서 올리도록 해보겠습니다...
Album.java
@Document 는 org.springframework.data.mongodb.core.mapping.Document 입니다.
이 어노테이션이 정의되면, MongoDB 의 Document 로 선언한 것입니다.
다음은 Album용 Repository를 정의합니다.
AlbumRepository.java
테스트용 환경 설정은 다음과 같이 합니다.
MongoConfiguration.java
주의할 점은 Repository 들을 실제 구현한 것이 아니라, Spring 이 동적으로 구현할 수 있도록 @EnableMongoRepositories 를 선언해 줘야 한다는 것입니다.
마지막으로 테스트 코드는 다음과 같습니다.
AlbumRepositoryIntegrationTest.java
를 구현하면 됩니다.
나머지 코드는 Spring-Data Mongo 의 예제에 있습니다. 그 예제는 xml 로 환경설정을 하고, 몇가지 제가 필요없는 코드를 제거했습니다.
시간나면 github에 따로 분리해서 올리도록 해보겠습니다...
Infinispan 캐시 저장소로 MongoDB 사용하기
분산캐시로 JBoss 에서 제작한 Infinispan 은 메모리 캐시로만 알고 있었는데, 여러가지 Cache Store 를 이미 제공하고 있더군요. 특히 Lucene 용이라던지, Jdbc 라던지...
Infinispan 5.3 부터는 MongoDB 를 캐시 저장소로 사용이 가능하더군요. 캐시 중에 영구 저장소에 저장해야 할 경우이면서, 빠른 PUT 성능이 필요로 하는 곳에 쓰면 좋을 것 같습니다.
우선 저는 Infinispan을 Hibernate 2nd cache 로 사용하기도 하는데요, RDBMS 보다야 캐시가 빠르지만, 보통은 휘발성이라 중간 접점이 있으면 좋겠다 싶었는데, Infinispan이 저장소로 NoSQL 을 사용할 수 있다면, 더 좋겠다 싶더군요.
제가 보통 이런 것의 사용처로는 통계성 데이터의 백데이터를 하루나 일주일 정도 캐시에 남겨 놓는 것입니다. 메모리가 제한적이니, NoSQL 에 저장했다가 거기서 로드해서 사용하고, RDBMS 는 처음 읽기만 하고 더 이상 접근하지 않는다면 좋겠다 싶어서지요.
그럼 Infinispan 과 MongoDB 를 활용해서 캐시를 사용해 보도록 하겠습니다.
우선 infinispan-core, infinispan-cachestore-mongodb 를 maven dependency 에 추가합니다. 현재 가장
최신 버전은 5.3.0.Final 입니다.
코드는 Infinispan을 사용하는 것과 같고, 다만 CacheStore를 설정해주는 부분만 새로 추가하면 됩니다.
여기서는 ConfigurationBuilder 를 이용하여 MongoDB CacheStore 설정을 수행했습니다.
MongoDbAsCaceStoreTest.java
보안을 위해서 username, password 도 설정이 가능합니다.
좀 더 자세한 내용은 Infinispan CacheStore 를 참고하세요.
참 MongoDB 에 접속하기 위해 Java 용 Driver 도 dependency에 추가해 주세요.
Infinispan 5.3 부터는 MongoDB 를 캐시 저장소로 사용이 가능하더군요. 캐시 중에 영구 저장소에 저장해야 할 경우이면서, 빠른 PUT 성능이 필요로 하는 곳에 쓰면 좋을 것 같습니다.
우선 저는 Infinispan을 Hibernate 2nd cache 로 사용하기도 하는데요, RDBMS 보다야 캐시가 빠르지만, 보통은 휘발성이라 중간 접점이 있으면 좋겠다 싶었는데, Infinispan이 저장소로 NoSQL 을 사용할 수 있다면, 더 좋겠다 싶더군요.
제가 보통 이런 것의 사용처로는 통계성 데이터의 백데이터를 하루나 일주일 정도 캐시에 남겨 놓는 것입니다. 메모리가 제한적이니, NoSQL 에 저장했다가 거기서 로드해서 사용하고, RDBMS 는 처음 읽기만 하고 더 이상 접근하지 않는다면 좋겠다 싶어서지요.
그럼 Infinispan 과 MongoDB 를 활용해서 캐시를 사용해 보도록 하겠습니다.
우선 infinispan-core, infinispan-cachestore-mongodb 를 maven dependency 에 추가합니다. 현재 가장
최신 버전은 5.3.0.Final 입니다.
코드는 Infinispan을 사용하는 것과 같고, 다만 CacheStore를 설정해주는 부분만 새로 추가하면 됩니다.
여기서는 ConfigurationBuilder 를 이용하여 MongoDB CacheStore 설정을 수행했습니다.
MongoDbAsCaceStoreTest.java
보안을 위해서 username, password 도 설정이 가능합니다.
좀 더 자세한 내용은 Infinispan CacheStore 를 참고하세요.
참 MongoDB 에 접속하기 위해 Java 용 Driver 도 dependency에 추가해 주세요.
2013년 7월 9일 화요일
IntelliJ 12 + lombok project plugin 이 동작하지 않을때...
IntelliJ 12용 lombok plugin 0.6.2 가 릴리즈되어 기쁜 마음으로 Upgrade 했습니다.
아니 근데.. 잘 되던 @Getter, @Setter 가 잘 안되네요...
쩝 뭐가 꼬였나... maven repository도 삭제해보고, pom 파일도 다시 import 해보고 테스트 해보니 maven으로는 제대로 작동하는데 IntelliJ 자체에서 작업 시 예외가 발생하더군요...
plugin 문제인가 싶어, rollback 하려다가 setting 창에 요런 게 새로 생겼네요 (그 전에도 있었나 모르겠지만, 전 지금 처음 알았습니다.)


요 화면과 같이 Compiler 내에 Annotation Processors 라는 항목이 있군요. 창 최상단에 있는 Enable annotation processing 항목을 check 해주고, 제일 아래의 "Apply" 버튼을 누른 후, lombok plugin 설정 창으로 가보면

다음과 같이 바뀌어 있을 겁니다. 아니면 Verify xxxx 버튼을 누르면 lombok 을 제대로 사용할 수 있는지 다시 평가해 줍니다.
흠 버전 업하면서, 옵션으로 변경되었나 봅니다.
요것때문에 한 시간을 허비했네 쩝...
아니 근데.. 잘 되던 @Getter, @Setter 가 잘 안되네요...
쩝 뭐가 꼬였나... maven repository도 삭제해보고, pom 파일도 다시 import 해보고 테스트 해보니 maven으로는 제대로 작동하는데 IntelliJ 자체에서 작업 시 예외가 발생하더군요...
plugin 문제인가 싶어, rollback 하려다가 setting 창에 요런 게 새로 생겼네요 (그 전에도 있었나 모르겠지만, 전 지금 처음 알았습니다.)

아니 뻘건 줄로 뭔 말을 썼는데... external compiler option? annotation processors? 을 활성화 시키라구? external compiler option 은 scala 에서만 쓰는 줄 알았는데? annotation processor 는 lombok 에서 필요한 기능인 줄 알겠는데... 저게 어디 있는건데?... 창에서 검색할 수 있으니 좋네요^^

요 화면과 같이 Compiler 내에 Annotation Processors 라는 항목이 있군요. 창 최상단에 있는 Enable annotation processing 항목을 check 해주고, 제일 아래의 "Apply" 버튼을 누른 후, lombok plugin 설정 창으로 가보면

다음과 같이 바뀌어 있을 겁니다. 아니면 Verify xxxx 버튼을 누르면 lombok 을 제대로 사용할 수 있는지 다시 평가해 줍니다.
흠 버전 업하면서, 옵션으로 변경되었나 봅니다.
요것때문에 한 시간을 허비했네 쩝...
2013년 7월 8일 월요일
Scala 와 Java 의 자료구조 변환 문제를 쉽게 해결합시다.
Scala의 장점 중에 하나가 상당히 다양하고, 강력한 자료구조 및 편의성을 제공하는 것입니다. 특히 자료구조를 병렬로 처리하는 것도 아주 쉽게 적용할 수 있습니다.
이런 Scala의 장점을 Java에서 사용하기 위해서 단순한 작업 두 가지만 해주면, Scala 의 강력한 자료구조를 쉽게 사용할 수 있습니다.
첫째는 maven으로 java와 scala 코드를 동시에 빌드할 수 있는 환경을 만드는 것이고,
둘째는 Java 자료구조와 Scala 자료구조를 쉽게 변환할 수 있도록 하는 것입니다.
첫째는 링크를 따라가시면 쉽게 환경을 구성할 수 있으니 생략하구요,
자료구조의 변환에 대한 코드만 보여드리겠습니다.
물론 제가 만든 게 아니라 Scala 에서 기본 제공하는 JavaConversions 라는 Object 를 사용하는 것입니다.
Java2Scala Object 를 보시면 모든 메소드가 implicit 로 정의되어 있습니다. 암묵 변환(implicit conversion) 이 되서, 개발자는 Object 를 import 하는 것으로 끝납니다.
Java2Scala.scala
java 코드에서 scala 메소드를 사용할 때, java 의 list 나 set 을 전달하면, 알아서 scala 의 ArrayBuffer 나 HashSet으로 변환하여 작업한 후 결과도 java 의 자료구조 형식으로 변환합니다.
scala 의 implicit 기능을 사용하면 엄청난 유연성이 생깁니다.
이런 Scala의 장점을 Java에서 사용하기 위해서 단순한 작업 두 가지만 해주면, Scala 의 강력한 자료구조를 쉽게 사용할 수 있습니다.
첫째는 maven으로 java와 scala 코드를 동시에 빌드할 수 있는 환경을 만드는 것이고,
둘째는 Java 자료구조와 Scala 자료구조를 쉽게 변환할 수 있도록 하는 것입니다.
첫째는 링크를 따라가시면 쉽게 환경을 구성할 수 있으니 생략하구요,
자료구조의 변환에 대한 코드만 보여드리겠습니다.
물론 제가 만든 게 아니라 Scala 에서 기본 제공하는 JavaConversions 라는 Object 를 사용하는 것입니다.
Java2Scala Object 를 보시면 모든 메소드가 implicit 로 정의되어 있습니다. 암묵 변환(implicit conversion) 이 되서, 개발자는 Object 를 import 하는 것으로 끝납니다.
Java2Scala.scala
java 코드에서 scala 메소드를 사용할 때, java 의 list 나 set 을 전달하면, 알아서 scala 의 ArrayBuffer 나 HashSet으로 변환하여 작업한 후 결과도 java 의 자료구조 형식으로 변환합니다.
scala 의 implicit 기능을 사용하면 엄청난 유연성이 생깁니다.
MySql Master Slave Replication 에서 Hibernate 사용하기 2
MySQL Master Slave Replication 에서 Hibernate 사용하기 에서 만든 ConnectionInterceptor 는 Custom Annotation을 사용하여, 부가적인 노가다가 필요했습니다.
보통 Spring 을 사용하니 Spring 의 @Transactional 을 이용하여, readOnly 속성에 따른 작업을 수행하면 될 것입니다.
제가 Spring Aop 에 초보라 좀 찾아보는데 시간이 걸리네요...
어쨌든 구글링을 통해 방법을 찾아서 개선된 ConnectionInterceptor 를 올립니다.
@Transactional을 사용하는 ConnectionInterceptor.java
보시다시피 @Transactional 이 정의된 메소드에 readOnly=true 인 경우에는 Slave 에 접속하게하고, 아니라면 그대로 실행하도록 합니다.
보통 Spring 을 사용하니 Spring 의 @Transactional 을 이용하여, readOnly 속성에 따른 작업을 수행하면 될 것입니다.
제가 Spring Aop 에 초보라 좀 찾아보는데 시간이 걸리네요...
어쨌든 구글링을 통해 방법을 찾아서 개선된 ConnectionInterceptor 를 올립니다.
@Transactional을 사용하는 ConnectionInterceptor.java
보시다시피 @Transactional 이 정의된 메소드에 readOnly=true 인 경우에는 Slave 에 접속하게하고, 아니라면 그대로 실행하도록 합니다.
2013년 7월 6일 토요일
MySQL Replication 환경 하에서 Hibernate 사용하기
타 RDBMS 보다 MySQL이 좋은 점 중에 하나가 다중 서버 환경으로의 전환이 용이하고, 안정적이라는 점이다. 보통의 Legacy 시스템에서는 RDBMS 서버 한대를 두고, 백업 서버를 두는 방식을 택하고, 성능이 모자라면 scale up 을 수행하는데, MySQL은 Replication을 이용하여 scale out 을 수행하므로서 부하 분산으로 성능을 높히는 방식입니다.

Hibernate의 경우 SessionFactory가 RDBMS 와 1:1 매핑이 되는 관계라 위와 같이 멀티 서버의 경우에는 중간에 Proxy 서버를 두던가, MySQL Replication Driver 를 이용해야 합니다.
Proxy 서버를 둔다는 것은 Clustering 을 구성하는 것과 같으니 Proxy 서버 주소만 알면 되지만, Replication Driver를 사용 시에는 Master / Slave 서버별로 작업의 특성에 따라 구분해 줘야 합니다.
즉 Master 서버는 Read/Write를 할 수 있지만, Slave 서버는 Read 작업만 수행해야 합니다. 이렇게 하려면 작업 전에 Connection 의 isReadOnly 속성을 변경하여, 원하는 종류의 서버를 선택하게끔 해야 합니다.
이를 위해 Spring AOP 를 이용하여, 작업 시작 전에 작업 종류에 따라 Connection 속성을 변경하는 interceptor 를 제작합니다.
ConnectionInterceptor.java
line 11 에 있는 @Arount 를 보시면, ReadOnlyConnection 이라는 annotation 이 있는 메소드를 intercept 하도록 합니다. 이 메소드는 readonly 작업을 뜻하므로 connection의 readonly 값을 true 로 하여, MySQL 의 Slave 서버에 접속하도록합니다.
ReadOnlyConnection annotation은 메소드에만 적용되도록 합니다.
ReadOnlyConnection.java
자 이제 테스트를 위한 서비스를 제작해 봅시다.
SimpleEntityServiceImpl.java
서비스 클래스에서 조회 메소드에서 @ReadOnlyConnection 을 사용하므로서 AOP 를 통해 ConnectionInterceptor 를 통해, Slave 서버에 접속하도록 했습니다.
이를 통해 Master/Slave 를 구분하고, 여러대의 Slave 도 Replication Driver 가 RoundRobin 방식으로 서버를 지정해주니, Application 개발자는 RDBMS 환경에 크게 신경 쓰지 않고, 자신의 분야에만 집중 할 수 있게 될 겁니다^^
또 한가지 SessionFactory가 하나로 유지되므로, 2nd Cache 도 하나가 되므로, 성능상의 잇점과 Cache와의 불일치에 대해 다른 방식보다 어느 정도 잇점이 있을 것입니다

Hibernate의 경우 SessionFactory가 RDBMS 와 1:1 매핑이 되는 관계라 위와 같이 멀티 서버의 경우에는 중간에 Proxy 서버를 두던가, MySQL Replication Driver 를 이용해야 합니다.
Proxy 서버를 둔다는 것은 Clustering 을 구성하는 것과 같으니 Proxy 서버 주소만 알면 되지만, Replication Driver를 사용 시에는 Master / Slave 서버별로 작업의 특성에 따라 구분해 줘야 합니다.
즉 Master 서버는 Read/Write를 할 수 있지만, Slave 서버는 Read 작업만 수행해야 합니다. 이렇게 하려면 작업 전에 Connection 의 isReadOnly 속성을 변경하여, 원하는 종류의 서버를 선택하게끔 해야 합니다.
이를 위해 Spring AOP 를 이용하여, 작업 시작 전에 작업 종류에 따라 Connection 속성을 변경하는 interceptor 를 제작합니다.
ConnectionInterceptor.java
line 11 에 있는 @Arount 를 보시면, ReadOnlyConnection 이라는 annotation 이 있는 메소드를 intercept 하도록 합니다. 이 메소드는 readonly 작업을 뜻하므로 connection의 readonly 값을 true 로 하여, MySQL 의 Slave 서버에 접속하도록합니다.
ReadOnlyConnection annotation은 메소드에만 적용되도록 합니다.
ReadOnlyConnection.java
자 이제 테스트를 위한 서비스를 제작해 봅시다.
SimpleEntityServiceImpl.java
서비스 클래스에서 조회 메소드에서 @ReadOnlyConnection 을 사용하므로서 AOP 를 통해 ConnectionInterceptor 를 통해, Slave 서버에 접속하도록 했습니다.
이를 통해 Master/Slave 를 구분하고, 여러대의 Slave 도 Replication Driver 가 RoundRobin 방식으로 서버를 지정해주니, Application 개발자는 RDBMS 환경에 크게 신경 쓰지 않고, 자신의 분야에만 집중 할 수 있게 될 겁니다^^
또 한가지 SessionFactory가 하나로 유지되므로, 2nd Cache 도 하나가 되므로, 성능상의 잇점과 Cache와의 불일치에 대해 다른 방식보다 어느 정도 잇점이 있을 것입니다
2013년 6월 26일 수요일
Play Framework 2 를 위한 에디터 - Sublime Text 2
처음 맥을 접했을 때, 맘에 드는 에디터를 못 찾아 헤메다가 지인의 추천으로 Sublime Text 2 에 정착했습니다.
요 놈이 생각보다 엄청 유명하더군요. 더군다나 엄청난 양의 Plug-In 이 있어 감탄했습니다.
요즘 Play 로 개발 중인데, IntelliJ IDEA 12 에서 개발 중에 html 파일 편집 시 Highlighting, format 등에 문제가 있더군요... 어차피 Play 같은 경우 console 과 editor 만으로도 개발이 가능하니까, sublime text 2 를 이용했습니다.
결과는 대 만족입니다.
내친김에 혹시 Play Framework 용 Plugin 이 있나 찾아 봤더니, Play 2 IDE 라는 Plugin 이 있네요. 제작자가 Play! Framework의 팬이라 잘만든 거 같습니다.
원본 소스 : play2-sublimetext2
뭐 HTML 에디팅은 전문 PlugIn 이 있으니, 요기서는 코드 snippet 을 지원합니다^^
Play! 로 개발 시에는 굳이 전문 IDE 가 필요 없을 듯^^
2013년 6월 9일 일요일
Hibernate-OGM 개요
Hibernate-OGM 에 대해 글을 쓰려고, 몇번 맘을 먹었지만... 다른 일이 많아서 못하다가 겨우 시작은 했습니다...
아직 부족한 부분도 많고, 기술적으로 세부적인 부분에 대해서는 더 작성해야 하지만, 이번에는 개요 수준에서 설명 자료를 만들어 봤습니다.
다음에는 Infinispan, MongoDB 에서 어떻게 데이터가 관리되는지 (CRUD) 에 대해 설명해 보도록 하겠습니다.
아직 부족한 부분도 많고, 기술적으로 세부적인 부분에 대해서는 더 작성해야 하지만, 이번에는 개요 수준에서 설명 자료를 만들어 봤습니다.
다음에는 Infinispan, MongoDB 에서 어떻게 데이터가 관리되는지 (CRUD) 에 대해 설명해 보도록 하겠습니다.
2013년 5월 27일 월요일
Time Period Library for JVM
기업용 솔루션을 만드는 경우 시간에 대한 계산이 참 많습니다.
특히, 일반적인 산술적 계산이 아니라 주말, 공휴일, 개인 휴가 (반차 포함), 팀 공가 등등을 고려한 작업 계획을 작성하려면 좀 복잡한 계산이 필요합니다.
이런 걸 일반적으로 Company Working Calendar 라고 하는데, 기간별 투입시간 등의 리소스 관리에 많은 기법이 동원됩니다.
예전 회사에서도 이 문제로 여러번에 걸쳐 발전시켰습니다만, 워낙 좋은 라이브러리가 있어서 이 넘의 forking 해서 사용했습니다.
원본 : Time Period Library for .NET
원본을 보면, 제가 원하는 기간 계산이나 최종일 계산등이 아주 구조적으로 할 수 있도록 구성되어 있습니다.
제가 여기에 몇가지 기능을 추가해서 사용했었는데요. .NET의 TPL 을 이용한 병렬 처리가 가장 기억에 남습니다.
올 1월에 scala 공부 겸 해서 scala 로 제작해 보자 해서 porting 을 수행하였습니다.
1. Time Period Library by Scala
뭐 Scala 로 제작했으니 JVM에서 돌구요. Scala의 Collection 지원과 여러가지 기능 (curry 등) 을 사용하였으니, scala 공부 시에는 도움이 될 듯 합니다.
문제는 제가 이넘 제작하다가 테스트 코드를 많이 못 만들어 버그가 많을 것이라는 것입니다^^
다음은 java 로 porting 한 소스입니다.
2. Time Period Library by Java
이넘은 debop4j 라이브러리 내에서 개발한 거라 debop4j-core 를 사용합니다.
기능은 위의 두 개와 같구요. java 코드라 좀 지저분하다는 점이 단점이지요^^
이 글을 빌어 원작자에게 감사드리며, 허락도 받지 않은 상태라 걱정도 되네요.
특히, 일반적인 산술적 계산이 아니라 주말, 공휴일, 개인 휴가 (반차 포함), 팀 공가 등등을 고려한 작업 계획을 작성하려면 좀 복잡한 계산이 필요합니다.
이런 걸 일반적으로 Company Working Calendar 라고 하는데, 기간별 투입시간 등의 리소스 관리에 많은 기법이 동원됩니다.
예전 회사에서도 이 문제로 여러번에 걸쳐 발전시켰습니다만, 워낙 좋은 라이브러리가 있어서 이 넘의 forking 해서 사용했습니다.
원본 : Time Period Library for .NET
원본을 보면, 제가 원하는 기간 계산이나 최종일 계산등이 아주 구조적으로 할 수 있도록 구성되어 있습니다.
제가 여기에 몇가지 기능을 추가해서 사용했었는데요. .NET의 TPL 을 이용한 병렬 처리가 가장 기억에 남습니다.
올 1월에 scala 공부 겸 해서 scala 로 제작해 보자 해서 porting 을 수행하였습니다.
1. Time Period Library by Scala
뭐 Scala 로 제작했으니 JVM에서 돌구요. Scala의 Collection 지원과 여러가지 기능 (curry 등) 을 사용하였으니, scala 공부 시에는 도움이 될 듯 합니다.
문제는 제가 이넘 제작하다가 테스트 코드를 많이 못 만들어 버그가 많을 것이라는 것입니다^^
다음은 java 로 porting 한 소스입니다.
2. Time Period Library by Java
이넘은 debop4j 라이브러리 내에서 개발한 거라 debop4j-core 를 사용합니다.
기능은 위의 두 개와 같구요. java 코드라 좀 지저분하다는 점이 단점이지요^^
이 글을 빌어 원작자에게 감사드리며, 허락도 받지 않은 상태라 걱정도 되네요.
2013년 5월 22일 수요일
hibernate-ogm 을 이용한 검색서비스 개발
올 3월 갑작스레 맡게 된 검색 서비스 개발 업무를 어떻게 할까 고민하다가 그래도 내가 잘하는 방법대로 얼른 만들어보자^^ 하면서 검색 관련 정보를 수집했습니다.
1. hibernate-search + lucene 를 사용한다.
2. 한글형태소 분석기가 있어야 한다.
3. 한글형태소 분석기의 품질은 사전이 정의한다.
라는 몇가지 룰과 정보를 얻었습니다...
검색 품질을 생각하지 않는다면 n-gram 을 사용하는 CJKAnalyzer 를 사용해도 됩니다만... 이 놈은 마지막 쵸이스로 놓고, 대강 hibernate-search 와 lucene 을 이용하여 개발했습니다...
몇가지 새로운 사실도 알아내고, 성능을 높힐 수 있었지만, 좀 더 욕심을 내서 다음과 같은 작업을 더 수행했습니다.
hibernate-search가 Index 정보를 sharding 할 수도 있더군요. 비동기 방식으로 index 작업할 수도 있구요.
1. hibernate-ogm 을 사용해보자. - MongoDB를 저장소로 사용한다.
2. 한글형태소 분석기를 써보자 (이수명씨 것을 기본으로 몇가지 수정 및 추가)
위 두 가지를 성공적으로 적용했습니다.
간단하게나마 발표자료로 만들었습니다.
다음에는 hibernate-ogm 자체에 대한 글을 써 볼까 합니다.
1. hibernate-search + lucene 를 사용한다.
2. 한글형태소 분석기가 있어야 한다.
3. 한글형태소 분석기의 품질은 사전이 정의한다.
라는 몇가지 룰과 정보를 얻었습니다...
검색 품질을 생각하지 않는다면 n-gram 을 사용하는 CJKAnalyzer 를 사용해도 됩니다만... 이 놈은 마지막 쵸이스로 놓고, 대강 hibernate-search 와 lucene 을 이용하여 개발했습니다...
몇가지 새로운 사실도 알아내고, 성능을 높힐 수 있었지만, 좀 더 욕심을 내서 다음과 같은 작업을 더 수행했습니다.
hibernate-search가 Index 정보를 sharding 할 수도 있더군요. 비동기 방식으로 index 작업할 수도 있구요.
1. hibernate-ogm 을 사용해보자. - MongoDB를 저장소로 사용한다.
2. 한글형태소 분석기를 써보자 (이수명씨 것을 기본으로 몇가지 수정 및 추가)
위 두 가지를 성공적으로 적용했습니다.
간단하게나마 발표자료로 만들었습니다.
다음에는 hibernate-ogm 자체에 대한 글을 써 볼까 합니다.
2013년 5월 19일 일요일
PostgreSQL 관련 추천 자료
PostgreSQL 을 공부하다보니, 한글 자료 및 국내 사례는 거의 없네요^^ 그래도 미국, 유럽, 일본에서는 상당히 많은 적용사례가 있고, 제게는 기능 상 MySQL 보다 더 매력적으로 다가오네요.
몇가지 PostgreSQL 관련 자료를 정리해 봅니다.
특히 제게는 PostgreSQL 자체의 많은 기능도 좋지만, pgpool-ii 같이 좋은 load balancing 이 있다는 것과 엄청난 extensions 들이 굳이 상용을 쓸 필요 있을까 싶네요^^
몇가지 PostgreSQL 관련 자료를 정리해 봅니다.
- 한눈에 살펴보는 PostgreSQL
- PostgreSQL 용 유용한 Extensions
- pgpool-ii tutorial ( connection pool, load balancing, replication 제공)
- hstore 란?
- hstore for java, java-hstore-sample ( key-value for PostgreSQL)
- pgmemcache Setup and Usage (memcache 를 이용한 캐시)
- PostreSQL 9.0 streaming replication + pgpool-ii
특히 제게는 PostgreSQL 자체의 많은 기능도 좋지만, pgpool-ii 같이 좋은 load balancing 이 있다는 것과 엄청난 extensions 들이 굳이 상용을 쓸 필요 있을까 싶네요^^
2013년 5월 7일 화요일
Spring framework 에서 static field에 injection 하기
Spring 전문가라면 모두 아시리라 믿습니다만, 전 .NET 에서 Castle.Windsor 를 주로 이용하여 Spring 이 좀 낫섭니다. 특히 static field 나 class 에 대한 정보가 별로 없더군요.
물론 제가 아직 Spring에 대한 내공이 부족하기도 하고, .NET의 Extension Methods 를 자주 사용하다보니 static class 를 습관적으로 많이 써서 생기는 문제일 수 있습니다. (이거 좋은 습관은 아닌데...)
어쨌든 기존 소스 중에 Singleton으로 써야 하고, static field 를 가진 클래스에 대해 injection을 수행해야 하는 것이 있었습니다. 다음과 같은 Class 가 있었습니다.
UnitOfWorks.java
UnitOfWorks 는 static field로 UnitOfWorkFactory를 가지고 있습니다. 이 필드를 Spring 이 injection을 할 수 있도록 해주고 싶었습니다.
xml 에서 작업하려면 MethodInvokingFactoryBean 을 이용하여 static method 를 호출하면 됩니다.
application-context.xml
xml 에서도 되는데 java configuration에서도 되겠지요?
그래서 구글링을 했더니 다행히, 몇번만에 해답을 찾았습니다.
원문: Spring annotations static injection tutorial
이 문서를 보고, 핵심은 원하는 클래스를 @Component로 지정하여 Spring Container에서 관리하도록하고, injection을 수행하도록 @Autowired를 지정하면 됩니다.
새로운 UnitOfWorks.java
UnitOfWorks 클래스는 @Component로 지정하고, @Autowired 해야 할 메소드는 static 이 아닌 instance method로 변경한 것으로 끝났다^^
마지막으로 Spring java configuration 에서 위의 UnitOfWorks를 ComponentScan 으로 등록해주면 됩니다.
StaticInjectionConfig.java
ComponentScan에서 UnitOfWorks class 를 지정해서 Component로 등록하게 하면, Bean으로 등록된 UnitOfWorkFactory가 injection이 됩니다^^
이로서 static field에 대해서도 java configuration에서 설정할 수 있게 되었습니다.
흠... Spring 에 대해 좀 더 공부해야겠네요...
xml 에서 작업하려면 MethodInvokingFactoryBean 을 이용하여 static method 를 호출하면 됩니다.
application-context.xml
xml 에서도 되는데 java configuration에서도 되겠지요?
그래서 구글링을 했더니 다행히, 몇번만에 해답을 찾았습니다.
원문: Spring annotations static injection tutorial
이 문서를 보고, 핵심은 원하는 클래스를 @Component로 지정하여 Spring Container에서 관리하도록하고, injection을 수행하도록 @Autowired를 지정하면 됩니다.
새로운 UnitOfWorks.java
UnitOfWorks 클래스는 @Component로 지정하고, @Autowired 해야 할 메소드는 static 이 아닌 instance method로 변경한 것으로 끝났다^^
마지막으로 Spring java configuration 에서 위의 UnitOfWorks를 ComponentScan 으로 등록해주면 됩니다.
StaticInjectionConfig.java
ComponentScan에서 UnitOfWorks class 를 지정해서 Component로 등록하게 하면, Bean으로 등록된 UnitOfWorkFactory가 injection이 됩니다^^
이로서 static field에 대해서도 java configuration에서 설정할 수 있게 되었습니다.
흠... Spring 에 대해 좀 더 공부해야겠네요...
2013년 5월 3일 금요일
Hibernate Criteria 의 장점
ORM의 대표격인 Hibernate 는 여러가지 장점 중에서도 질의어에 대한 지원 방식 풍부하다는 점이다.
이 있다.
SQL 에 익숙한 개발자들은 Criteria 의 가능성 및 효용성에 대해 느껴보지 못하고, 과소평가하는 경우가 많은데, 이 때 제가 아주 간단한 과제를 통해, Criteria 의 장점을 체험하게 합니다.
간단한 과제: 작업 기간에 대해 검색 조건으로 시작시각과 완료시각을 입력 받아 겹치는 기간에 있는 작업 정보를 조회하는 SQL 쿼리를 작성해 보시오.
위의 과제를 주면 99.9% 다 틀립니다. 0.1% 해결한다 하더라도, 너무 복잡해 다른 사람들은 사용하기에도 힘들 것입니다.
위 문제의 첫번째 난관은 기간에 해당하는 시작시각과 완료시각이 nullable 임을 인지하는 것입니다. 두 번째는 검색하고자하는 시작시각과 완료시각도 nullable 일 수 있다는 것입니다. 그럼 이런 조건 하에서 검색을 위한 질의어를 만드는데 경우의 수는 몇이나 될까요?
간단하게 2*2*2*2 = 2^4 이죠?
뭐 중딩 1차원 그래프까지 그려가면서 설명할 필요 없겠죠?
이걸 SQL 쿼리문으로 나타내라구요?
뭐 할 수는 있겠지요... 다만, 차라리 Criteria 라는 좋은 방식이 있으니 그걸 이용해 보라는 겁니다.
결론부터 말하면 다음과 같이 구현하면 됩니다.
OverlapCriteria
뭐 null 값인지 검사해서 알맞은 메소드를 호출하면 되네요^^
헐... 근데 내부에 보니 Between 과 InRange 라는 연산자를 사용하네요... 이건 뭐죠?
Between (일반적인 쿼리문에서는 A <= X <= B 이다. 경계값을 포함하는 closed 이다)
InRange 는 Between 과 대상과 검사 값이 반대일 뿐이다.
자 이제 Criteria 가 SQL 문보다 논리적으로 쉽게 구현되는지 알겠는가?
SQL문을 먼저 배웠다고, 좀 더 익숙하다고 그게 진리는 아닙니다.
java가 되었건, csharp 이 되었건, scala 가 되었건 익숙한 것보다 유용하게 표현할 수 있는 방식이 있다면 그게 진리입니다.
- Criteria
- 프로그램 언어로 빌더 패턴을 차용한 방식으로 질의를 빌드합니다.
- 사용자 정의의 Criteria 를 정의하여 사용할 수 있습니다.
- Criteria 를 실제 SQL 문으로 변환하는데 비용이 드는 단점이 있습니다.
- HQL (Hibernate Query Language)
- hibernate 고유의 질의어입니다.
- SQL 표준 문법과 유사하지만 새로 배워야 합니다.
- 변환에 드는 비용이 한번만 있고, 캐시하여 사용하므로 성능 상 유리합니다.
- SQL String
- 기존 표준 문법이므로 장단점이 따로 없습니다.
- ORM 에서도 그냥 사용해도 된다는 점
이 있다.
SQL 에 익숙한 개발자들은 Criteria 의 가능성 및 효용성에 대해 느껴보지 못하고, 과소평가하는 경우가 많은데, 이 때 제가 아주 간단한 과제를 통해, Criteria 의 장점을 체험하게 합니다.
간단한 과제: 작업 기간에 대해 검색 조건으로 시작시각과 완료시각을 입력 받아 겹치는 기간에 있는 작업 정보를 조회하는 SQL 쿼리를 작성해 보시오.
위의 과제를 주면 99.9% 다 틀립니다. 0.1% 해결한다 하더라도, 너무 복잡해 다른 사람들은 사용하기에도 힘들 것입니다.
위 문제의 첫번째 난관은 기간에 해당하는 시작시각과 완료시각이 nullable 임을 인지하는 것입니다. 두 번째는 검색하고자하는 시작시각과 완료시각도 nullable 일 수 있다는 것입니다. 그럼 이런 조건 하에서 검색을 위한 질의어를 만드는데 경우의 수는 몇이나 될까요?
간단하게 2*2*2*2 = 2^4 이죠?
뭐 중딩 1차원 그래프까지 그려가면서 설명할 필요 없겠죠?
이걸 SQL 쿼리문으로 나타내라구요?
뭐 할 수는 있겠지요... 다만, 차라리 Criteria 라는 좋은 방식이 있으니 그걸 이용해 보라는 겁니다.
결론부터 말하면 다음과 같이 구현하면 됩니다.
OverlapCriteria
뭐 null 값인지 검사해서 알맞은 메소드를 호출하면 되네요^^
헐... 근데 내부에 보니 Between 과 InRange 라는 연산자를 사용하네요... 이건 뭐죠?
Between (일반적인 쿼리문에서는 A <= X <= B 이다. 경계값을 포함하는 closed 이다)
InRange 는 Between 과 대상과 검사 값이 반대일 뿐이다.
자 이제 Criteria 가 SQL 문보다 논리적으로 쉽게 구현되는지 알겠는가?
SQL문을 먼저 배웠다고, 좀 더 익숙하다고 그게 진리는 아닙니다.
java가 되었건, csharp 이 되었건, scala 가 되었건 익숙한 것보다 유용하게 표현할 수 있는 방식이 있다면 그게 진리입니다.
2013년 5월 2일 목요일
redis 를 hibernate 2nd cache 로 사용하기 - part 2
hibernate-redis 제작 - part 1
hibernate-redis 제작 - part 2
redis 가 캐시 시스템으로 사용하기 좋다는 것은 여러 사례에서 알 수 있고, SNS 같은 경우에는 Timeline 정보를 캐싱하는데 자주 사용하지요.
이런 redis 를 hibernate 의 2nd cache 저장소로 사용하면 좋겠다고 생각해서, hibernate-redis 를 제작했습니다.
첫번째 버전은 제가 Redis에 대해 잘 몰라, 그냥 Spring Data Redis 를 사용하여, 구현했습니다.
개발하다보니 Jedis 만을 사용하여 개발하는 것이 더 가볍게 개발 할 수 있을 것 같아, Spring Data Redis 를 걷어내고, Jedis 만을 사용하여 개발했습니다.
hibernate-redis 는 현재 0.9.0 이고, 단위 테스트를 통과한 상태입니다.
아직 실전 테스트가 남아 있습니다^^
이번 글에서는 일반적인 캐시로서 Redis를 이용할 때, 직접 jedis 를 사용할 수도 있지만, 좀 더 쉽게 만든 JedisClient 에 대해 소개하기로 하겠습니다.
JedisClient.java
JedisClient 를 굳이 따로 만든 이유는 JedisPool 사용과 Transactional 작업이 반복적인 코드라 Jedis 만 사용하게되면 코드가 많아질까봐 Spring Data Redis 와 유사하게 만들었습니다.
물론 Jedis 의 모든 메소드를 지원하지는 않습니다. 캐시로 사용할 때 필요한 기능만을 구현했습니다.
이를 바탕으로 일반 저장소로 사용 가능하도록 확장할 수 있을겁니다.
특히 ShardedJedis 를 사용하려면, 다른 방법을 사용해야 합니다. 이 방식은 대용량 캐시나 저장소로 사용할 때 고려해 봐야 겠습니다.
참고로 JedisPool 설정 정보도 도움이 될겁니다.
2013년 4월 30일 화요일
ThreadContext 별 저장소를 활용한 Spring Scope 확장
제가 닷넷으로 개발할 때, IoC/DI framework 으로 Castle.Windsor 를 사용했습니다. NInject, Spring.NET 등도 있었지만... Castle.Windsor 가 가장 앞서 나갔고, Fluent 방식으로 Component 를 등록하는 것도 지원했습니다.
자바에서는 Spring Framework 이 거의 표준이라서 별 생각없이(?) 잘 쓰고 있습니다. 다만 한가지 아쉬운 점은 같은 Thread Context 별로 다른 Bean (Component) 를 사용하고 싶은데... 할 수 있는 것이라곤...
scope 가 singleton 이거나 prototype 이란 거... 즉 프로세스에 오직 하나의 인스턴스만 있거나, 요청 시 매번 새로운 인스턴스를 준다는 것이지요. 물론 웹에서는 PerSession 등이 있습니다만, 내부 라이브러리에서는 Thread Context 별로 Bean을 제공하는 방식이 추가되었으면 좋겠다 싶었습니다.
Windsor Castle 에는 thread 라고 지정해주면 Thread Context 별로 독립된 인스턴스를 제공해 주거든요^^
그래서 만들어 봤습니다.
우선 Bean 을 정의하는데, 일반적으로 단순 생성해서 주는 게 아니라. TheadLocal을 이용하여, 생성된 인스턴스를 보관하여, 같은 ThreadContext 에서 Bean을 요청하는 경우, 기존 인스턴스를 제공하는 것입니다.
ThreadLocal 에 초기 값을 지정해주고, 필요 시마다 ThreadLocal 의 인스턴스를 제공해 주는 것입니다.
이렇게 하면, Thread Context 별로 다른 인스턴스를 사용하여, 독립적인 작업을 수행할 수 있고, 같은 Thread Context에서는 반복적인 조회에도 같은 인스턴스를 제공할 수 있습니다.
Thread 별로 제공해야 하는 Bean 이 많은 경우에는 위와 같은 작업이 번거로울 수 있습니다. 이럴 때에는 thread 별로 hash map 을 제공하는 것이 좋습니다.
위와 같이 같은 Thread 에서는 하나의 hash map 을 공유하게 되므로, 여러 Class 들간에 인자 전달 방식이 아니더라도, thread 단위로 값을 공유할 수 있습니다.
이렇게 Local 을 이용하여 기존 ThreadLocal 방식을 다시 구현하면
과 같습니다. Bean 마다 ThreadLocal 을 따로 만들지 않아 좋은 장점이 있습니다.
자바에서는 Spring Framework 이 거의 표준이라서 별 생각없이(?) 잘 쓰고 있습니다. 다만 한가지 아쉬운 점은 같은 Thread Context 별로 다른 Bean (Component) 를 사용하고 싶은데... 할 수 있는 것이라곤...
scope 가 singleton 이거나 prototype 이란 거... 즉 프로세스에 오직 하나의 인스턴스만 있거나, 요청 시 매번 새로운 인스턴스를 준다는 것이지요. 물론 웹에서는 PerSession 등이 있습니다만, 내부 라이브러리에서는 Thread Context 별로 Bean을 제공하는 방식이 추가되었으면 좋겠다 싶었습니다.
Windsor Castle 에는 thread 라고 지정해주면 Thread Context 별로 독립된 인스턴스를 제공해 주거든요^^
그래서 만들어 봤습니다.
우선 Bean 을 정의하는데, 일반적으로 단순 생성해서 주는 게 아니라. TheadLocal을 이용하여, 생성된 인스턴스를 보관하여, 같은 ThreadContext 에서 Bean을 요청하는 경우, 기존 인스턴스를 제공하는 것입니다.
ThreadLocal 에 초기 값을 지정해주고, 필요 시마다 ThreadLocal 의 인스턴스를 제공해 주는 것입니다.
이렇게 하면, Thread Context 별로 다른 인스턴스를 사용하여, 독립적인 작업을 수행할 수 있고, 같은 Thread Context에서는 반복적인 조회에도 같은 인스턴스를 제공할 수 있습니다.
Thread 별로 제공해야 하는 Bean 이 많은 경우에는 위와 같은 작업이 번거로울 수 있습니다. 이럴 때에는 thread 별로 hash map 을 제공하는 것이 좋습니다.
위와 같이 같은 Thread 에서는 하나의 hash map 을 공유하게 되므로, 여러 Class 들간에 인자 전달 방식이 아니더라도, thread 단위로 값을 공유할 수 있습니다.
이렇게 Local 을 이용하여 기존 ThreadLocal 방식을 다시 구현하면
과 같습니다. Bean 마다 ThreadLocal 을 따로 만들지 않아 좋은 장점이 있습니다.
2013년 4월 29일 월요일
NIO2 AsynchronousFileChannel 사용 예제
작은 크기의 파일을 읽을 때에는 JDK 1.7 의 Files.readAllLines() 를 사용하면 땡입니다. 하지만 무지 큰 파일을 읽기, 쓰기를 할 경우에는 Disk IO 작업만으로 많은 시간이 걸려, 다른 작업을 못하게 됩니다. 이럴땐 무조건 비동기 작업으로 변환해야 합니다.
왜? 뭐하러? 비동기 작업이 만들기도 어렵고, 버그 발생 시 처리하기도 힘든데...
맞는 말이기도 하지만, 메모리와 CPU에서 처리하는 작업도 비동기 작업으로 처리하는데, 네트웍이나 DISK IO라면 수 천배, 수 만배 느린데, 이것을 비동기로 처리해서, 다른 작업을 처리해 줄 수 있다면 시스템 전체의 작업 효율이 엄청 높아질 것입니다.
Redis 가 초기에 Master/Slave replication 방식을 동기식으로만 지원하다가 비동기 방식도 지원하게 된 이유도 같은 이치라 보시면 됩니다.
자 이제 본격적으로 비동기 방식의 파일 읽기/쓰기를 해보기로 합시다. JDK 1.7 NIO 2 에 보면 기존 NIO 보다 확장되고 향상된 기능이 많습니다.
아직도 JDK 1.7을 쓰지 않는 시스템이나 NIO2 를 쓰지 않는 시스템을 보면 아쉬움이 크네요.
다들 얼른 빨리 업그래이드해서 고성능 기능을 활용하면 좋을텐데 하는 맘입니다.
우선 NIO 2 를 이용하는 방식 중 작은 파일을 다룰 때에는 버퍼링되는 스트림을 사용하는 것이 가장 쉽고, 편합니다.
BufferedReader, BufferedWriter 사용 법은 Files 클래스를 사용하면 끝납니다.
Files.newBufferedWriter, Files.readAllLines 등 내부적으로 BufferedReader, BufferedWriter를 사용합니다. 버퍼링을 통해, DiskIO 작업 횟수를 적게, 한꺼번에 처리하도록합니다.
다음으로는 대용량의 데이터를 파일로 처리할 경우 비동기 방식으로 처리해주는 AsynchronousFileChannel 의 사용법에 대해 보겠습니다. 이름에서 보시다시피 비동기 방식으로 파일의 데이터를 처리합니다.
대용량 데이터를 쓰는 예
데이터를 쓰는 경우도 많은 데이터를 쓰는 동안 다른 일을 처리할 수 있으므로, Future.isDone() 을 검사하여 다른 작업을 처리할 수도 있고, 다른 작업을 처리한 후 Future.get() 을 통해 작업 결과를 알 수 있습니다.
대용량 데이터를 읽는 예
데이터를 읽을 때, isDone() 은 UI 처리 등을 수행할 수 있고, 단순히 get() 으로 기다릴 수도 있습니다.
주의사항 : 테스트 코드라 읽고 난 후 파일을 삭제하게 해 놨으니, 실전에서는 필요에 따라 옵션을 지정해 주세요.
마지막으로 byte[]로 읽어드린 내용이 텍스트라면, List 수형으로 변경해주는 것이 좋겠죠?
라인 처리는 OS 시스템마다 다 다른데, BufferedReader 가 잘 되어 있더군요 ㅋ
자 이렇게 BufferedReader 를 이용하여 작업을 처리했습니다.
왜? 뭐하러? 비동기 작업이 만들기도 어렵고, 버그 발생 시 처리하기도 힘든데...
맞는 말이기도 하지만, 메모리와 CPU에서 처리하는 작업도 비동기 작업으로 처리하는데, 네트웍이나 DISK IO라면 수 천배, 수 만배 느린데, 이것을 비동기로 처리해서, 다른 작업을 처리해 줄 수 있다면 시스템 전체의 작업 효율이 엄청 높아질 것입니다.
Redis 가 초기에 Master/Slave replication 방식을 동기식으로만 지원하다가 비동기 방식도 지원하게 된 이유도 같은 이치라 보시면 됩니다.
자 이제 본격적으로 비동기 방식의 파일 읽기/쓰기를 해보기로 합시다. JDK 1.7 NIO 2 에 보면 기존 NIO 보다 확장되고 향상된 기능이 많습니다.
아직도 JDK 1.7을 쓰지 않는 시스템이나 NIO2 를 쓰지 않는 시스템을 보면 아쉬움이 크네요.
다들 얼른 빨리 업그래이드해서 고성능 기능을 활용하면 좋을텐데 하는 맘입니다.
우선 NIO 2 를 이용하는 방식 중 작은 파일을 다룰 때에는 버퍼링되는 스트림을 사용하는 것이 가장 쉽고, 편합니다.
BufferedReader, BufferedWriter 사용 법은 Files 클래스를 사용하면 끝납니다.
Files.newBufferedWriter, Files.readAllLines 등 내부적으로 BufferedReader, BufferedWriter를 사용합니다. 버퍼링을 통해, DiskIO 작업 횟수를 적게, 한꺼번에 처리하도록합니다.
다음으로는 대용량의 데이터를 파일로 처리할 경우 비동기 방식으로 처리해주는 AsynchronousFileChannel 의 사용법에 대해 보겠습니다. 이름에서 보시다시피 비동기 방식으로 파일의 데이터를 처리합니다.
대용량 데이터를 쓰는 예
데이터를 쓰는 경우도 많은 데이터를 쓰는 동안 다른 일을 처리할 수 있으므로, Future.isDone() 을 검사하여 다른 작업을 처리할 수도 있고, 다른 작업을 처리한 후 Future.get() 을 통해 작업 결과를 알 수 있습니다.
대용량 데이터를 읽는 예
데이터를 읽을 때, isDone() 은 UI 처리 등을 수행할 수 있고, 단순히 get() 으로 기다릴 수도 있습니다.
주의사항 : 테스트 코드라 읽고 난 후 파일을 삭제하게 해 놨으니, 실전에서는 필요에 따라 옵션을 지정해 주세요.
마지막으로 byte[]로 읽어드린 내용이 텍스트라면, List
라인 처리는 OS 시스템마다 다 다른데, BufferedReader 가 잘 되어 있더군요 ㅋ
자 이렇게 BufferedReader 를 이용하여 작업을 처리했습니다.
2013년 4월 18일 목요일
Apache Avro IDL protocol 을 비동기 방식으로 통신하기
연속해서 Avro 에 대해 글을 쓰게 되네요. 이번 프로젝트에 Avro를 사용할 것이고, 팀원들이 쉽게 쓰게 하기 위해서 이 글을 씁니다. ㅋ
Netty 덕분에 Avro 의 통신이 믿을만하고, 속도도 빠르다고 확신합니다만, 개발자 분들도 비동기 방식을 사용하여 더 효과적인 통신이 되도록 하면 좋을 것입니다.
CalculatorServer.java ( 이전 글의 예제를 비동기 방식도 가능하도록 수정)
입니다. 이전 코드에서 변경된 부분은 다음과 같습니다.
변경된 부분만!!!
비동기 방식 통신을 위해서는 Client 를 얻을 때 Calculator.class 를 쓰지 않고, Calculator.Callback.class 를 사용합니다. 이 interface 는 이미 Avro에 의해 생성된 코드입니다.
이를 바탕으로 Callback을 직접 정의해도 되고, CallFuture 를 사용해도 됩니다.
Netty 덕분에 Avro 의 통신이 믿을만하고, 속도도 빠르다고 확신합니다만, 개발자 분들도 비동기 방식을 사용하여 더 효과적인 통신이 되도록 하면 좋을 것입니다.
CalculatorServer.java ( 이전 글의 예제를 비동기 방식도 가능하도록 수정)
입니다. 이전 코드에서 변경된 부분은 다음과 같습니다.
변경된 부분만!!!
비동기 방식 통신을 위해서는 Client 를 얻을 때 Calculator.class 를 쓰지 않고, Calculator.Callback.class 를 사용합니다. 이 interface 는 이미 Avro에 의해 생성된 코드입니다.
이를 바탕으로 Callback을 직접 정의해도 되고, CallFuture
피드 구독하기:
글 (Atom)